
De l'ETL à l'ELT
On charge d'abord les données brutes dans l'entrepôt, puis on les transforme sur place. Les données d'origine sont conservées, et ajouter un indicateur demande moins de travail.
Vos chiffres sont éparpillés entre la boutique en ligne, l'ERP, le CRM, les plateformes publicitaires et des fichiers Excel. Nous construisons une architecture de données moderne qui les collecte, les nettoie et les relie automatiquement, dans votre propre environnement.


Les données de chaque outil arrivent automatiquement, sont rangées dans une base unique, transformées une seule fois, puis mises à disposition de toutes vos équipes.
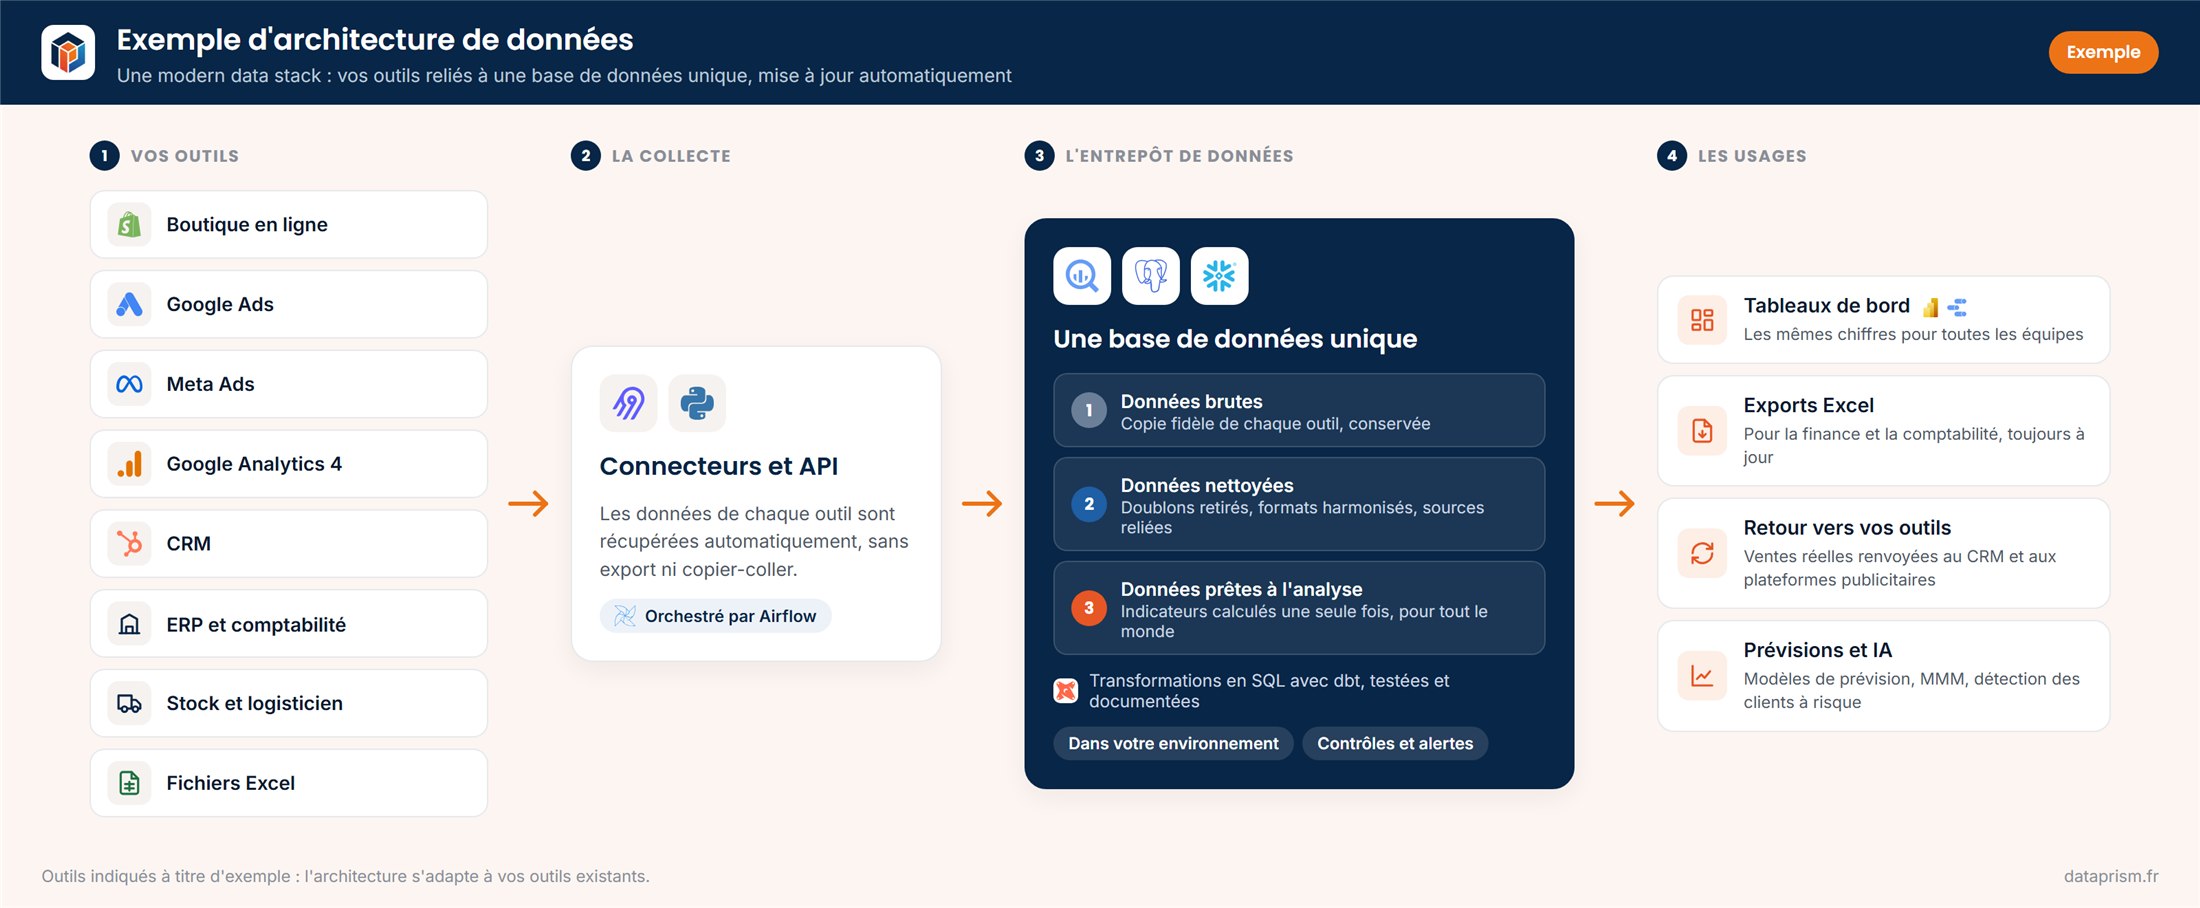
Connecteurs et API récupèrent automatiquement les données de chaque outil, à la fréquence qui vous convient. Fini les exports et le copier-coller.
Tout est rangé dans un entrepôt de données (BigQuery, PostgreSQL ou Snowflake), en conservant une copie fidèle des données d'origine.
Les données sont nettoyées, reliées entre elles et transformées en indicateurs, avec des règles de calcul communes à toute l'entreprise.
Des tests vérifient les chiffres avant qu'ils n'arrivent dans les tableaux de bord, et une alerte prévient si une source ne répond plus.
Ces outils étaient réservés aux grandes entreprises. Avec le cloud, ils sont devenus accessibles aux PME.
On charge d'abord les données brutes dans l'entrepôt, puis on les transforme sur place. Les données d'origine sont conservées, et ajouter un indicateur demande moins de travail.
Les règles de calcul s'écrivent en SQL avec dbt, se testent et se documentent comme du code. Chacun sait d'où vient chaque chiffre.
Données brutes, données nettoyées, données prêtes à l'analyse : chaque étape est séparée, ce qui rend les erreurs faciles à retrouver.
Les entrepôts dans le cloud se paient à l'usage : pour une PME, le coût reste modeste. Pas de serveur à acheter ni à entretenir.
 Python
 Airbyte
 Airflow
 dbt
 BigQuery
 PostgreSQL
 Snowflake
L'entrepôt est installé dans votre propre compte cloud. Vous en êtes propriétaire, avec tous les accès.
Deux ou trois sources pour répondre à une première question, puis on ajoute les autres. Vous voyez le résultat vite.
Le code est versionné et documenté. Votre équipe, ou une autre, peut le reprendre à tout moment.
Pipelines Airflow, migration de centaines de requêtes SQL vers dbt, synchronisation avec l'ERP NetSuite, entrepôt BigQuery.
Modèle de données dbt en architecture médaillon, pipelines Airflow, encadrement d’une équipe data.
Audit et refonte du traitement des données : dbt, Airflow, Airbyte, datamarts PostgreSQL.
Pour aller plus loin : Data pipeline : comment vos données brutes deviennent des décisions · Pourquoi un entrepôt de données plutôt qu'un connecteur de plus ?
Non. Nous partons de vos outils actuels (boutique en ligne, ERP, CRM, comptabilité, plateformes publicitaires, fichiers Excel) et nous les relions entre eux. Vos équipes continuent de travailler comme avant.
Par la question la plus urgente (la marge par canal, la trésorerie, le suivi des stocks) et les deux ou trois sources qui y répondent. Les autres sources s'ajoutent ensuite, une par une.
Dans votre propre environnement cloud (Google Cloud, AWS, Azure ou OVH), dans la région de votre choix, par exemple en Europe. Vous en êtes propriétaire, et vous gardez les accès.
Nous pouvons l'auditer, le reprendre ou le compléter : fiabiliser les transformations, ajouter des tests, documenter les indicateurs, améliorer les performances.
Au choix : nous assurons le suivi, ou nous formons vos équipes. Le code est versionné et documenté, pour que n'importe quelle équipe data puisse le reprendre.
Ce n'est pas obligatoire, mais c'est souvent utile : l'audit dit quelles sources relier en premier et quels indicateurs suivre. Voir l'audit data →
Un premier échange de 30 minutes, gratuit, en visio ou autour d'un café à Montpellier, pour voir quelles données relier en premier.
Choisir un créneau 30 min
 Vous échangez avec Armelle ou Florian.