

Les données d’une entreprise sont rarement au même endroit : les ventes dans la boutique en ligne ou l’ERP, les dépenses dans les plateformes publicitaires, les clients dans le CRM, le reste dans des fichiers Excel. Pour qu’elles servent à décider, il faut les réunir, les nettoyer et les relier. C’est le rôle d’un pipeline de données (data pipeline).
Les six étapes d’un pipeline
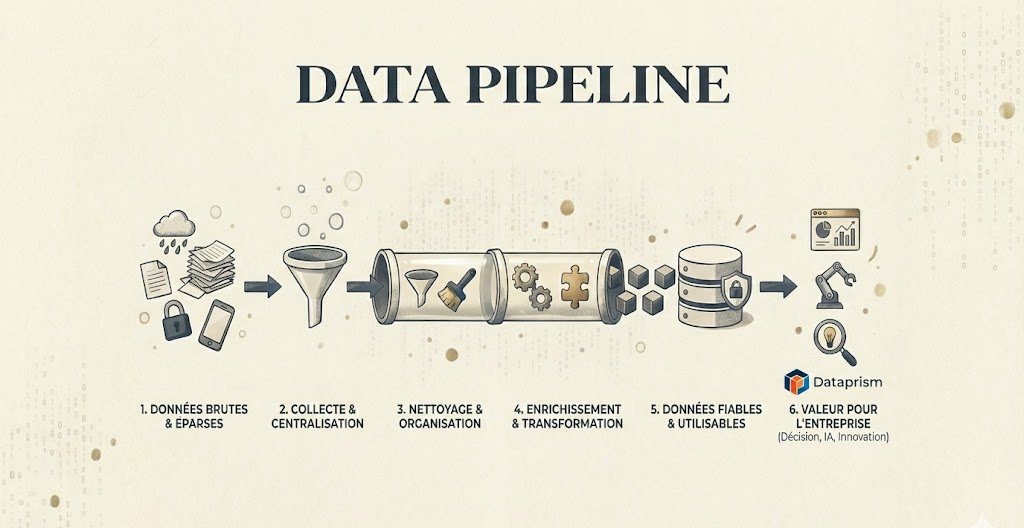
- Des données brutes et éparses : chaque outil a son format, ses noms de colonnes, sa façon de compter.
- La collecte et la centralisation : les données de chaque outil sont récupérées automatiquement, le plus souvent par leurs API, et rangées au même endroit.
- Le nettoyage et l’organisation : doublons supprimés, formats harmonisés, valeurs manquantes repérées.
- L’enrichissement et la transformation : les données sont reliées entre elles (une commande à son client, à sa campagne, à ses coûts) et les règles de calcul sont écrites une seule fois.
- Des données fiables et utilisables : tout le monde parle du même chiffre, calculé de la même façon.
- De la valeur pour l’entreprise : des tableaux de bord, des analyses, des modèles de prévision, et des décisions mieux informées.
Tant que ces étapes sont faites à la main, elles prennent du temps chaque semaine et laissent passer des erreurs. Un pipeline les automatise.
De l’ETL à l’ELT
Pendant longtemps, les pipelines suivaient l’approche ETL : extraire les données, les transformer, puis les charger dans une base. Les transformations se faisaient avant le stockage, sur des serveurs dédiés.
Avec les entrepôts de données dans le cloud, comme BigQuery ou Snowflake, l’ordre s’est inversé : c’est l’approche ELT. On charge d’abord les données brutes, puis on les transforme directement dans l’entrepôt. Cela a plusieurs avantages :
- les données d’origine sont conservées, on peut toujours revenir en arrière ;
- les transformations s’écrivent en SQL, avec des outils comme dbt, et se versionnent comme du code ;
- ajouter une nouvelle source ou un nouvel indicateur demande moins de travail.
Entrepôt, lac de données, lakehouse
Trois mots reviennent souvent :
- l’entrepôt de données (data warehouse) stocke des données structurées, prêtes pour l’analyse ;
- le lac de données (data lake) stocke tout, y compris des données non structurées (textes, images, journaux techniques), à moindre coût ;
- le lakehouse cherche à réunir les deux dans une même architecture.
Pour une PME dont les données viennent surtout d’outils de gestion, de vente et de marketing, un entrepôt de données bien organisé suffit le plus souvent.
Et le data mesh ?
Dans les grandes organisations, une équipe data centrale peut devenir un goulot d’étranglement. Le data mesh confie alors la responsabilité des données à chaque domaine métier, qui les publie comme un produit pour les autres. C’est une réponse à un problème de grande taille : dans une PME, une architecture centralisée reste plus simple et moins coûteuse.
Ce qui fait un bon pipeline
Au-delà des technologies, quelques principes font la différence :
- automatique : il tourne tout seul, sans intervention ;
- testé : des contrôles vérifient que les chiffres sont cohérents avant qu’ils n’arrivent dans les tableaux de bord ;
- surveillé : une alerte prévient quand une source ne répond plus ;
- documenté : chaque indicateur a une définition écrite ;
- à vous : l’entrepôt est installé dans votre environnement, et vous en êtes propriétaire.
Par où commencer ?
Inutile de tout construire d’un coup. On commence par les deux ou trois sources qui répondent à la question la plus urgente (la marge par canal, la trésorerie, le suivi des stocks), puis on ajoute les autres. C’est ce que nous mettons en place dans nos projets de centralisation des données, souvent après un audit data.
Et vous, combien de temps passez-vous chaque mois à rassembler vos chiffres ?
Pour aller plus loin : Dhiraj Naphade, « The Evolution and Modernization of Data Pipeline Architectures », European Journal of Computer Science and Information Technology, 2025.
